ภาพและเสียง + สูตรภาษาไทย
Image and voice on the i9 · the Thai recipe
TL;DR — สรุปใน 30 วินาทีtldr
บทนี้ "เสริม" ไม่บังคับ — ถ้าอยากให้ AI วาดภาพ และ พูดภาษาไทย ได้เหมือนคลาวด์เต็มๆ เราใช้ ComfyUI หลายเตารวมกันเป็น "ครัว" เดียว + ตัวสังเคราะห์เสียงไทย VoxCPM2 และตัวถอดเสียง Whisper บน i9
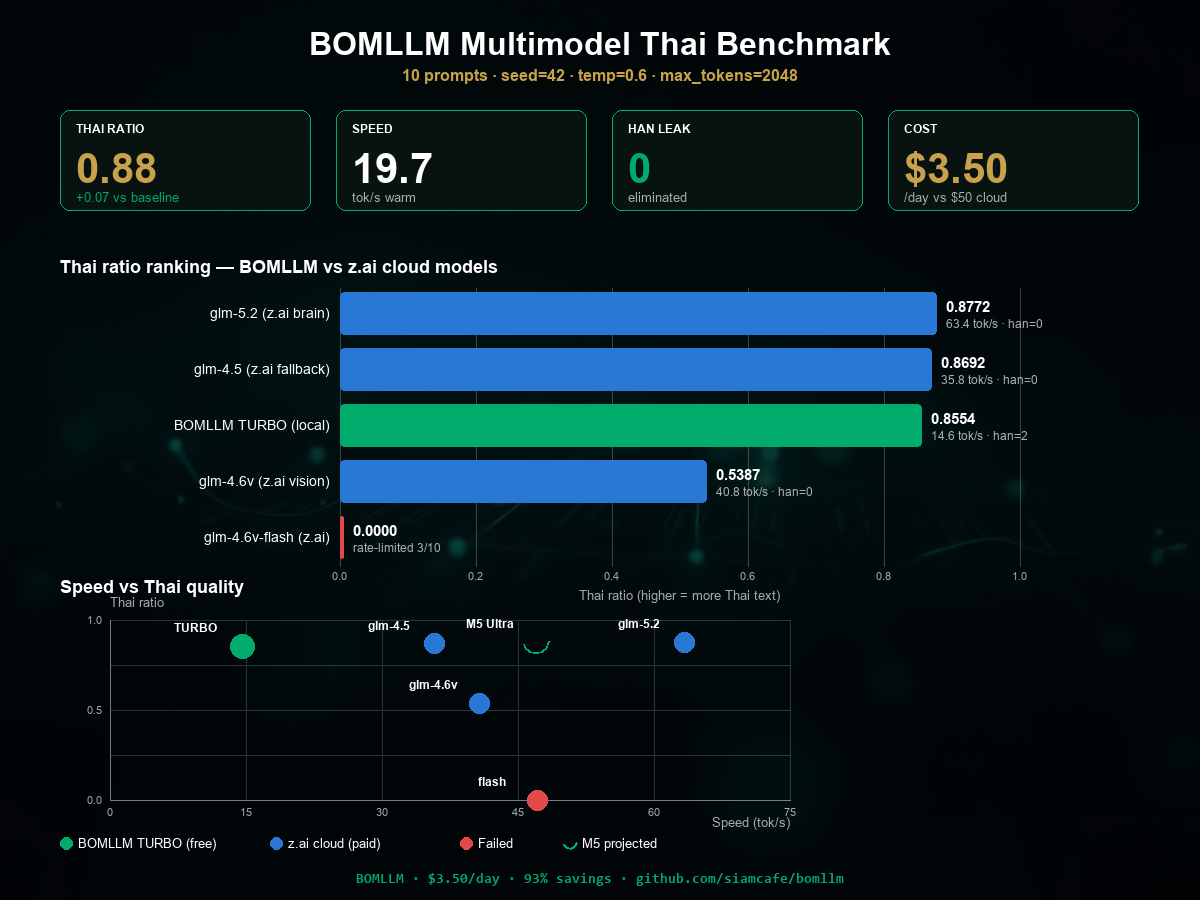
บทนี้คือ "มงกุฎ" ของทั้งคู่มือ — วิธีทำให้โมเดลเปิดตอบภาษาไทย ดีพอจนแทนคลาวด์ที่เคยจ่ายเงินได้จริง ทุกค่าที่เห็นผ่านการทดสอบแบบมีเกณฑ์ (50 เคสจริง ให้คะแนนโดยกรรมการ 2 ตัว) ไม่ใช่ความรู้สึก
| ตัวชี้วัด | BOMLLM (Mac 27B MLX) | คลาวด์เดิม (GLM-4.5-Flash) | ผล |
|---|---|---|---|
| คะแนนรวม (1–10) | 7.24 | 6.02 | ชนะ 1.20 เท่า ✅ |
| คุณภาพถาม-ตอบ LINE | 8.93 | 6.33 | ชนะ 1.41 เท่า ✅ |
| ความเร็วคำตอบ (ค่ากลาง) | 5.2 วิ | 35.1 วิ | เร็ว ~7 เท่า ✅ |
| อัตรา error (30 วิ) | 4% (2/50) | 0% | ยอมรับตรง ๆ ⚠️ |
| ความบริสุทธิ์ไทย (thai_ratio) | 0.797 (0.832 แบบเข้ม) | 0.762 | สูงกว่า ✅ |
| ตัวจีนหลุด (ต่อ 100 คำตอบ) | 15 | 43 | น้อยกว่าครึ่ง ✅ |
เมื่อไหร่ควรใช้ / When to usewhen to use
ทำเมื่อมีเครื่องการ์ดจอ NVIDIA ว่างอยู่ (เราใช้ i9 + 2× RTX 5060 Ti + เครื่อง AMD อีกหนึ่งใบ) — ถ้าไม่มี ข้ามบทนี้ได้ ระบบหลักไม่กระทบนะครับ
- ครัวภาพเราเป็นแบบ "เตาหลายใบ": ComfyUI บน i9 GPU0 (:8188), GPU1 (:8190), และเครื่อง AMD อีกเตา — มีตัวจ่ายงาน (comfy-router) บน NAS คอยส่งงานไปเตาที่ว่างสุด
- เสียงพูดไทย: VoxCPM2 บน i9 (:9499) — ใช้ทั้งอ่านคำตอบเป็นเสียงและพากย์วิดีโอ
- ถอดเสียงเป็นตัวอักษร: Whisper (:9200) — ใช้ทำคำบรรยายวิดีโอ
ใช้สูตรนี้ทันทีที่โมเดลลงเครื่องแล้ว (บทที่ ๓) — และกลับมาอ้างอิงทุกครั้งที่เปลี่ยนโมเดล/เวอร์ชัน เพราะ "พารามิเตอร์ที่ดี" เป็นของเฉพาะคู่ (โมเดล + ชุดข้อมูล) ไม่ย้ายฟรีข้ามโมเดลนะครับ
วิธีทำ / How-tohow to
โครงสร้างครัว 3 เตา + ตัวจ่ายงาน:
- ติดตั้ง ComfyUI ทีละเตา (GPU หนึ่งใบต่อ instance, พอร์ตต่างกัน) — ดาวน์โหลดจาก github.com/comfyanonymous/ComfyUI
- ตั้งค่า เตาทุกใบเข้ากฎ GPULAW: หน้าต่างเรนเดอร์ภาพคือ 17:30–19:30 ของทุกวัน — นอกหน้าต่างให้ GPU ว่าง
- ตัวจ่ายงาน comfy-router (FastAPI) บน NAS :8788 รับคำขอเดียว แล้วส่งต่อเตาที่ยุ่งน้อยสุด (least-busy) — มี /free ให้ดูสถานะเตาแบบเรียลไทม์
- เสียง: รัน VoxCPM2 และ Whisper เป็น service บน i9 แล้วเปิดปุ่ม TTS/STT ในหน้า WebUI
- ทดสอบปลายทาง: ขอภาพจากหน้าแชท (พิมพ์ให้ "วาดรูป...") และกดปุ่มลำโพงอ่านคำตอบ
ภาพจริงของครัวทั้งสามเตาอยู่ในหัวข้อภาพประกอบด้านล่าง — จากระบบที่กำลังรันอยู่จริงตอนถ่ายนะครับ
ถ้าติดตรงไหน → บทที่ ๙
ชั้นที่ 0 ก่อน — พื้นความปลอดภัยของ completion (สำคัญสุด แต่คนมองข้าม): อาการ "ภาษาไทยแรง ๆ อ่อน ๆ สลับกันไป" ที่เราเคยเจอ (thai_ratio แกว่ง 0.72–0.92) ต้นตอไม่ใช่ prompt แต่คือ คำตอบถูกตัด/ว่างเปล่า เพราะเพดานคำตอบ (num_predict) น้อยเกินไปชนกับ "ความคิดในใจ" ของโมเดล — เมื่อยกพื้นให้ถูก การแกว่งหดเหลือแค่แถบกว้าง 0.036 และคำตอบครบ 300/300:
# พื้นความปลอดภัย (ใส่ก่อนแต่ง prompt ใด ๆ)
num_ctx: 32768          # ต่ำกว่านี้ รายงานไทยยาว ๆ โดนตัดหางครับ
num_predict: 8192       # งานเขียนยาวครับ
num_predict_chat: 2048  # แชทปกติ ครับ
num_predict_bot: 1024   # บอท LINE/Telegram (งบ UX 30 วินาที) ครับ
think: false            # เฉพาะเส้นทางบอท — เหตุผลด้านล่าง
ที่มา: การทดสอบ 300/300 completions, ก.ย. 2026 — รายละเอียดใน docs/thai.md ครับ
กับดัด "งบความคิด" ของบอท: โมเดลแบบ reasoning เปิด think คู่กับ num_predict น้อย จะเผาโควตาคำตอบทั้งหมดไปกับการคิดในใที่ แล้วส่งกลับ คำตอบว่างเปล่า — บอท LINE ของเราเคยโดนจริง ทางแก้คือ pin think:false + เพดานตอบตามขนาดงาน (ตั้งไว้แล้วในบทที่ ๔)
ชั้นที่ 1 — พารามิเตอร์ sampling ที่ผ่านประตู:
# Config A_bom_nothink — ตัวเดียวที่ผ่านประตู 0.78 จากการทดสอบ 4 คอนฟิก
temperature: 0.7
top_p: 0.8
top_k: 20
repeat_penalty: 1.05    # เกินนี้ทำลาย code block ครับ
# วัดจริง: thai_median 0.7821, Han 12 ครั้ง/28 คำตอบ, 17.92 tok/s
สิ่งที่เคยตั้งสมติฐานแล้วถูกหักล้างด้วยการทดลอง: presence_penalty 1.5 "ไม่" ทำให้ไทยแย่ลง (A/B n=23 ไม่ต่างกัน), sampling สูตร DavidAU ไม่ชนะ incumbent (0.7500 vs 0.7821) นะครับ
ชั้นที่ 2 — system prompt สูตร "Config G": โครงสร้าง 4 ส่วน (ตัวเต็ม 4,101 ตัวอักษร อยู่ใน repo และ Hugging Face bomllm/turbo-thai-config):
- ตัวตน + บุคลิก (ผู้ช่วยไทย สุภาพ โดเมนการเงิน/เทค)
- กฎภาษา: ตอบภาษาไทยเสมอ (เว้นแต่ผู้ใช้ใช้ภาษาอื่น) + ห้ามส่งออกอักษรจีนโดยเด็ดขาด (Han ban)
- กฎสไตล์: ตอบตรงคำถามก่อน ไม่มีน้ำ ไม่แต่งตัวเลข
- ตัวอย่างคู่ถาม-ตอบ 2 คู่ (few-shot: หนึ่งทั่วไป หนึ่งแบบรายงาน)
ผลวัดจริงของ Config G: thai_ratio +0.029 เหนือ prompt คู่แข่ง (CI 95% ไม่ครอบศูนย์) และอักษรจีนหลุดลงครึ่งหนึ่ง (35 → 15 ต่อ 100) นะครับ
ถ้าติดตรงไหน → บทที่ ๙
ตัวอย่างการตั้งค่า / Config exampleconfig example
หลักการตั้งค่าครัวที่เราใช้จริงครับ:
# เตาหนึ่ง = GPU หนึ่งใบ = พอร์ตหนึ่งตัว
i9 GPU0 :8188   (ComfyUI — งานภาพทั่วไป) ครับ
i9 GPU1 :8190   (ComfyUI — งาน PuLID ติดหน้าคน) ครับ
AMD     :8188   (ComfyUI — เตาที่สาม รับล้น) ครับ

# ตัวจ่ายงานบน NAS
comfy-router :8788
  POST /generate      -> ส่งไปเตาที่ว่างสุดอัตโนมัติ
  GET  /free          -> ดู VRAM คงเหลือของทุกเตา

# เสียงบน i9
VoxCPM2 TTS :9499   (ข้อความไทย -> เสียงพูด)
Whisper STT :9200   (เสียง -> ข้อความ, ใช้ทำซับไทย)
กฎ GPULAW 17:30–19:30 ถูกเขียนอยู่ในตารางงานของ router โดยตรง — นอกเวลา งานเข้าคิวไม่รีบเตานะครับ
แปะลงใช้จริง — route ของ LiteLLM (บทที่ ๔) + ไฟล์ configs/sampling-recipe.yaml ใน repo คือ "ใบเสร็จ" ทุกค่า:
# สรุปสูตรสำเร็จสำหรับโมเดล 27B บน Mac (สูตรที่รันอยู่ใน production)
system_prompt : Config G (ไทยเท่านั้น + ห้ามอักษรจีน + few-shot 2 คู่) ครับ
temperature   : 0.7      top_p: 0.8     top_k: 20
repeat_penalty: 1.05     presence_penalty: 0.0
num_ctx       : 32768
num_predict   : 8192 เขียนยาว / 2048 แชท / 1024 บอทครับ
think         : false บนเส้นทางบอท, true เฉพาะเส้นทาง deep
อย่าลองผสมเองแบบสุ่ม — ทุกค่าในนี้มีการทดลองรองรับ และมันเจ็บจริงเวลาพัง (repeat_penalty 8.0 พิมพ์ผิดครั้งเดียว = ผลลัพธ์พังทั้งก้อน) นะครับ
Pro tip — เคล็ดลับจากสนามจริงpro tip
คำถามที่พบบ่อย / FAQfaq
ถาม: การ์ดจอเก่า ๆ ใช้ได้ไหม? — RTX 16GB รุ่นไหนก็เริ่มได้ ถ้าน้อยกว่านั้นต้องเลือกโมเดลภาพเล็กลง (SDXL แทน Flux)
ถาม: เสียงไทยเนียนแค่ไหน? — ระดับ "ฟังเข้าใจสบาย พากย์งานจริงได้" เราใช้ผลิตวิดีโอ YouTube จริงทุกสัปดาห์ (ตัวอย่างอยู่ที่ YouTube @icafefx)
คำถามอื่น ๆ ดูที่ FAQ
ถาม: แล้วถามภาษาอังกฤษล่ะ ตอบภาษาไหน? — สูตรมาตรฐานของเราตอบไทยก่อนเสมอ (เจ้าของธุรกิจเลือกแบบนี้) ถ้าอยากให้ภาษาอังกฤษเทคนิคตอบอังกฤษ มี override ระดับ route — แต่เตรียมใจว่าค่าความบริสุทธิ์ไทยจะขยับ
ถาม: โมเดลใหม่ออกมาต้องเริ่มใหม่ไหม? — โปรโตคอลเดิมรันซ้ำได้ (สคริปต์ bench_thai.py ใน repo) โมเดลท้าชิงต้องชนะ incumbent แบบ CI ไม่ครอบศูนย์จึงจะได้เลื่อน
ดูเพิ่ม / See alsosee also
- บทที่ ๑ · สถาปัตยกรรม 4 เครื่อง — ตำแหน่งของครัวในภาพใหญ่
- บทที่ ๓ · Mac Mini — ที่อยู่ของโมเดลที่รับสูตรนี้
- บทที่ ๗ · บอท — ที่ think:false สร้างความต่าง
- บทที่ ๘ · Content pipeline — ผู้ใช้ภาพหนักที่สุดของครัว
- Hugging Face — ชุดสูตรภาษาไทยฉบับเต็ม
ภาพประกอบ / Figuresfigures
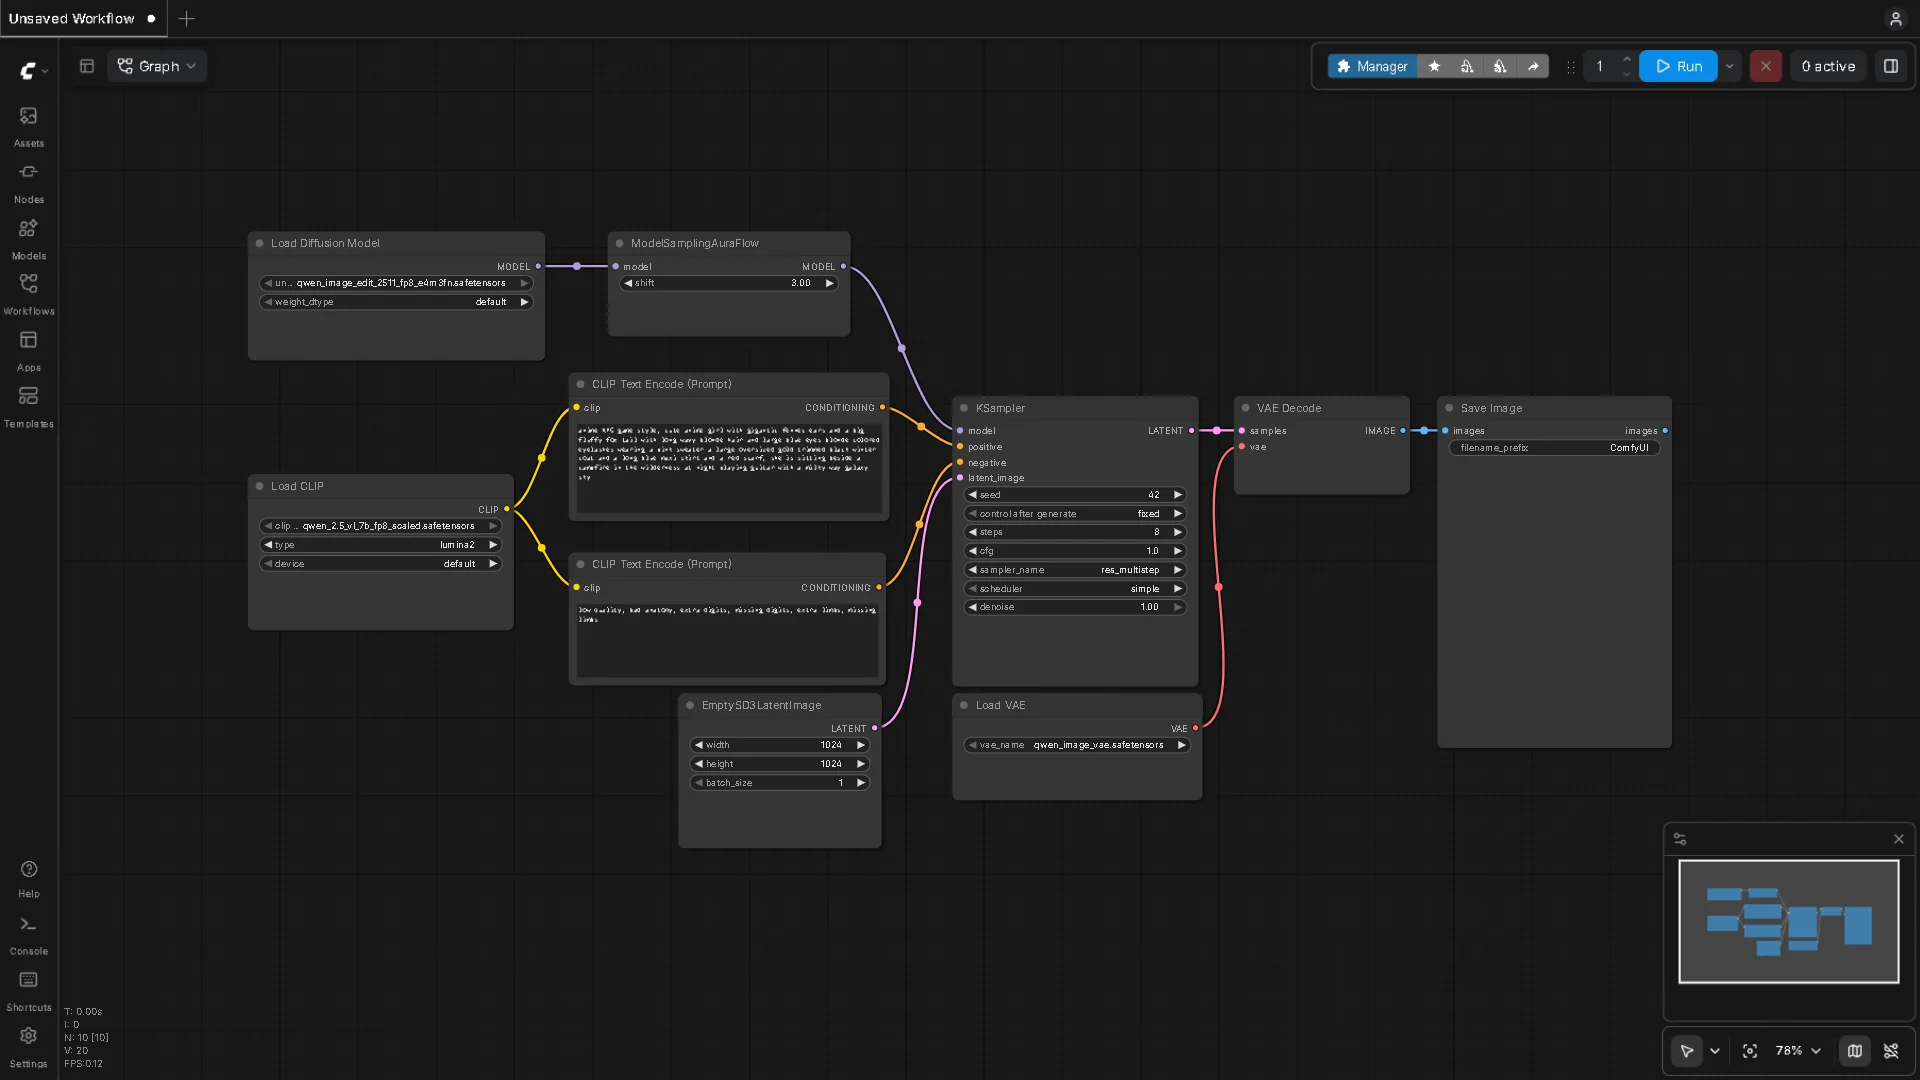
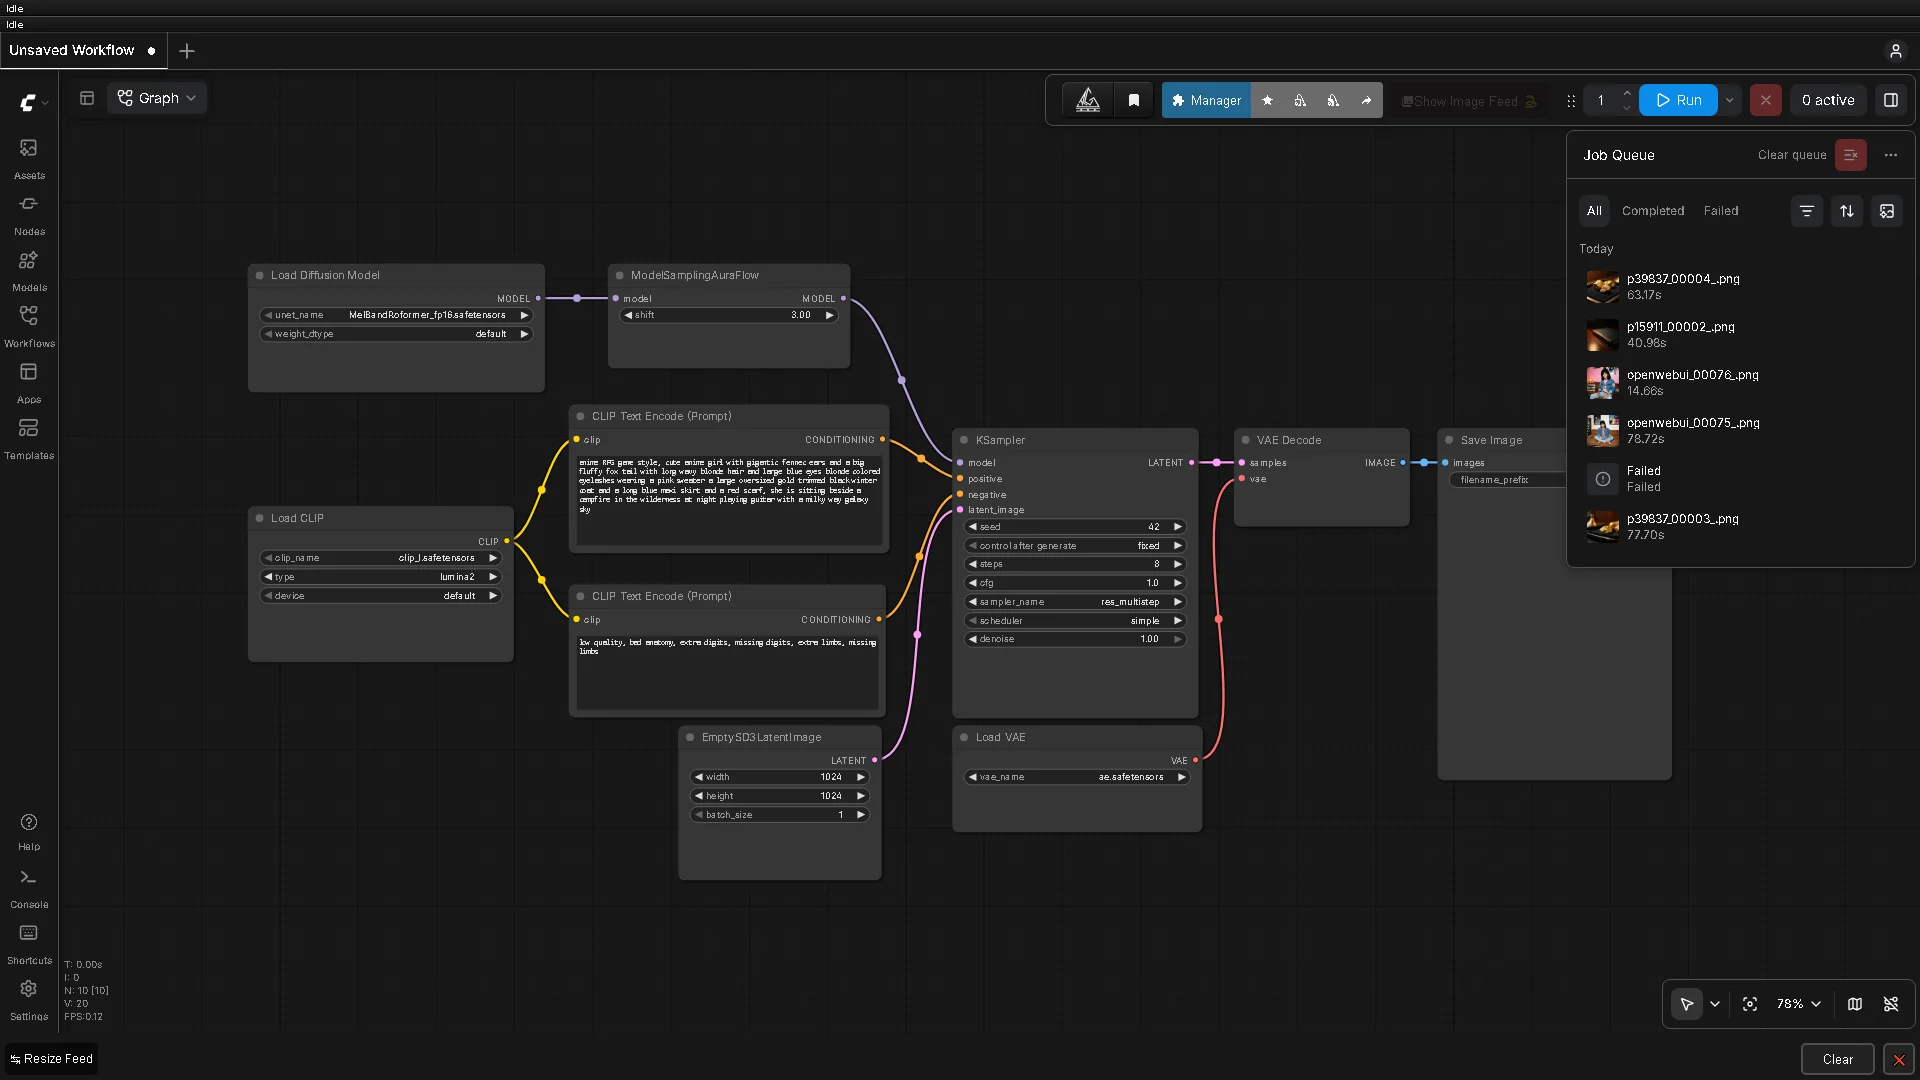
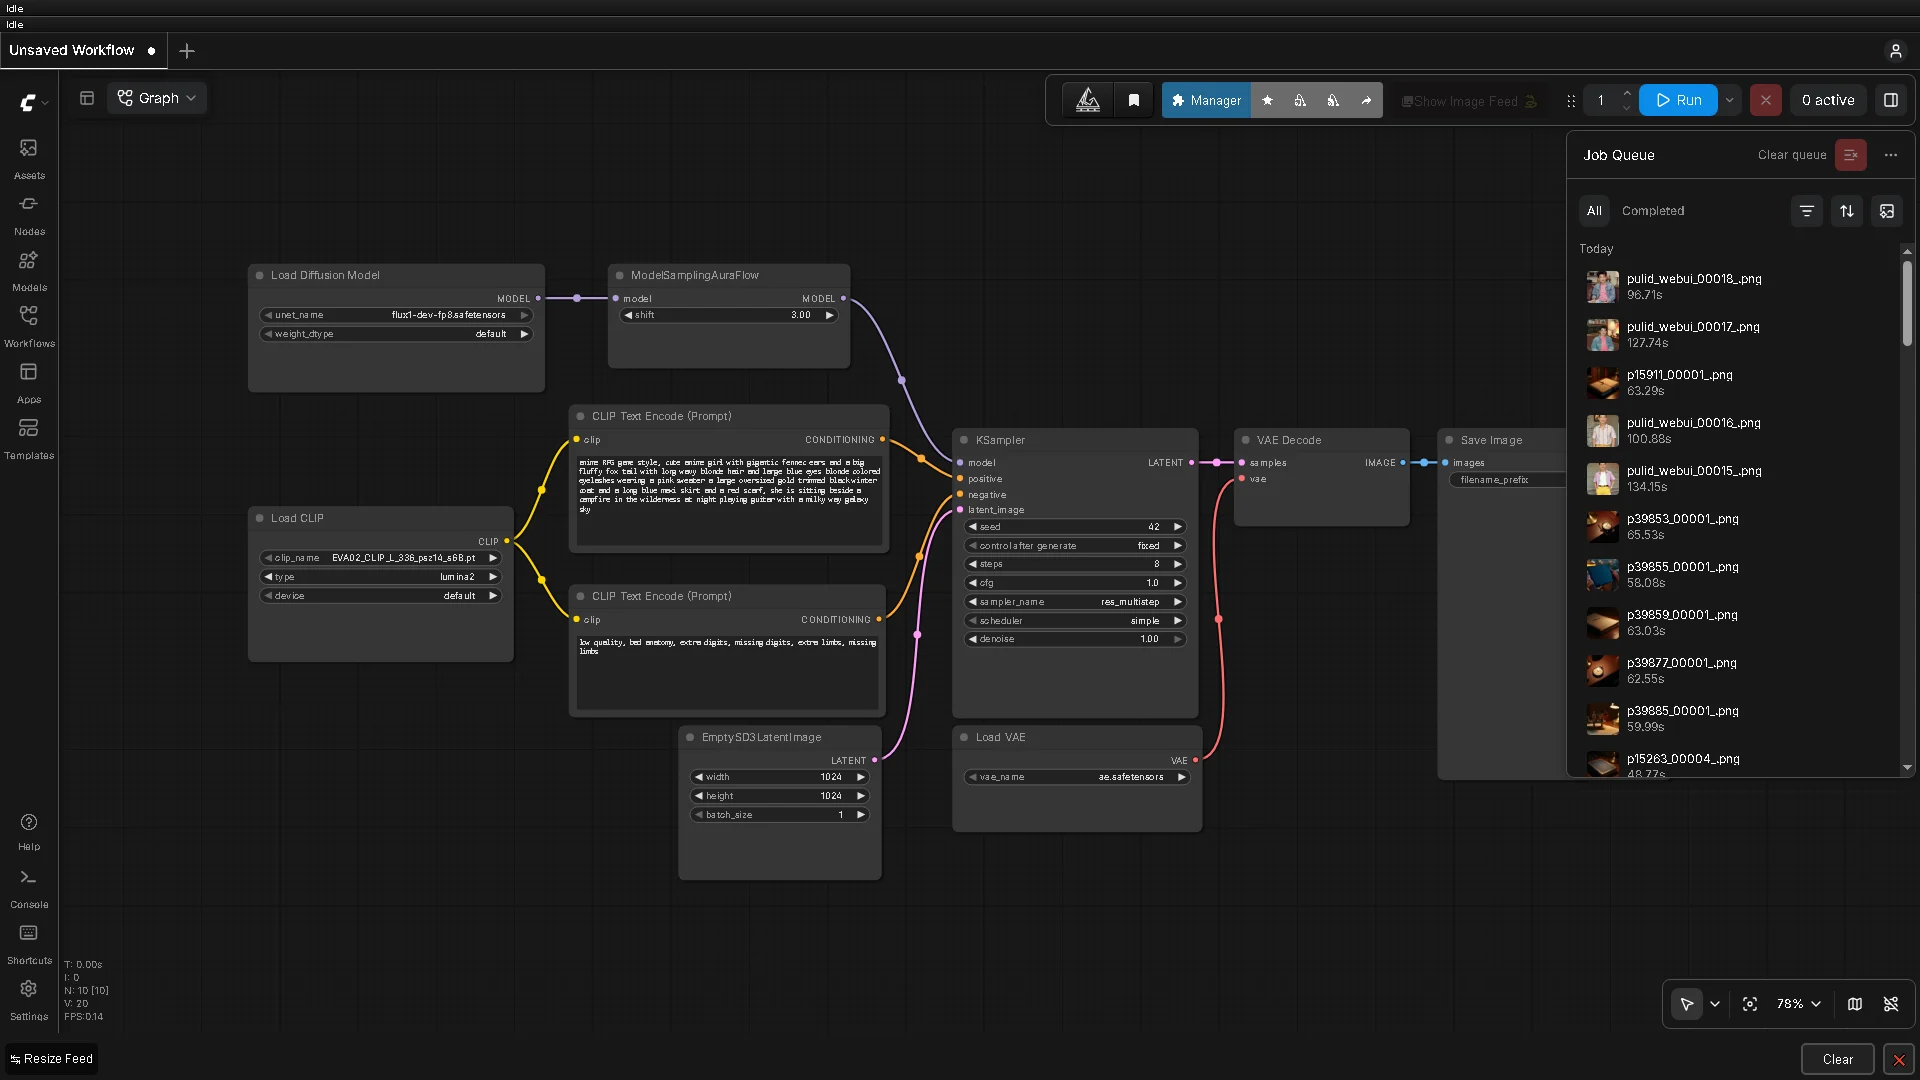
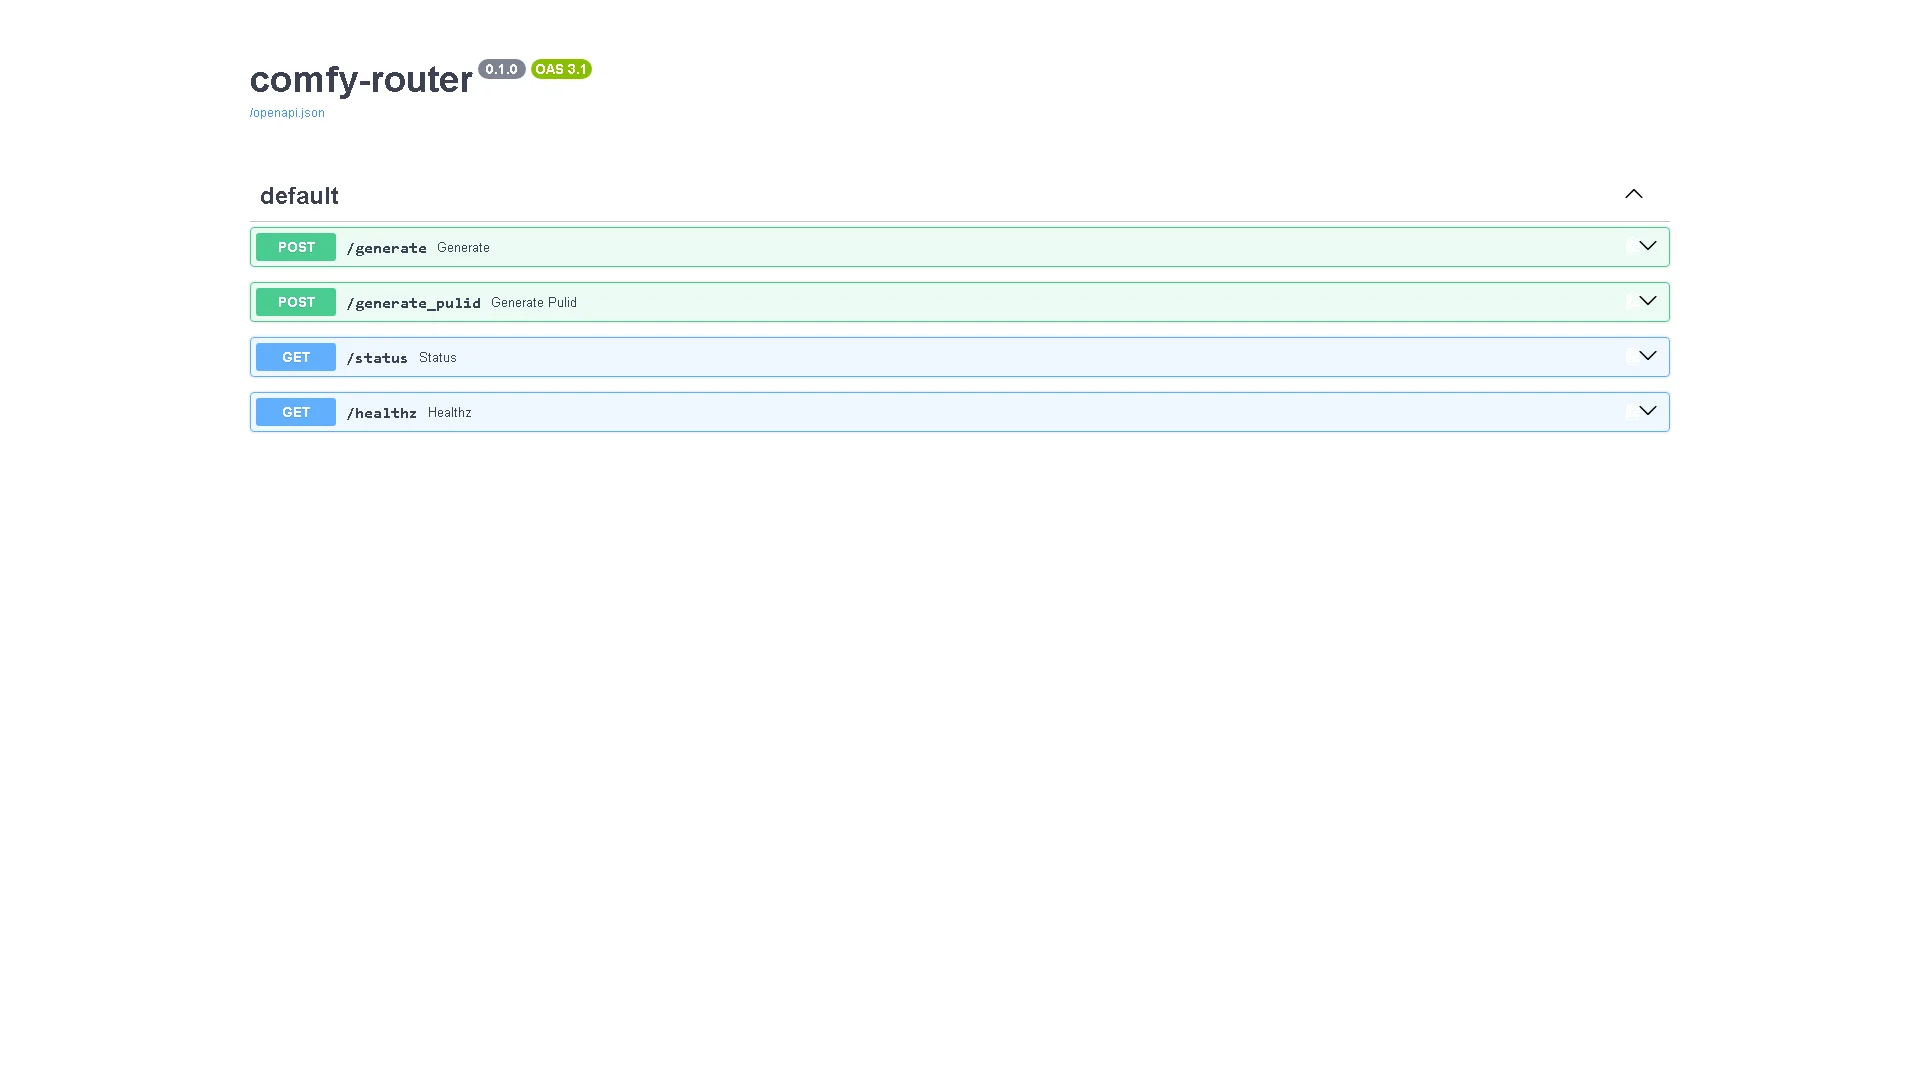
คลิปหน้าจอจริงตามบทเรียน · คลิกเล่นเพื่อฟังสรุป · ไม่ใช่คำแนะนำการลงทุนครับ
▶ ดูวิดีโอคู่มือ: https://youtu.be/O4hM39cgDCY